01
Intake
导入 AI hunter、scanner、红队、PSIRT、bug bounty 或外部 assessment 的发现,保留来源、scope、owner、资产和原始证据。
365UI — 面向高风险工作流的企业私有 AI 系统
Superagent 与 OrgMem 驱动企业私有知识工作流;BMC Red-Team Lab 与 Ironclad 则把同样的可追溯、审批、证据与审计纪律应用到 AI 基础设施安全。
以可复用平台为底座,由深入现场的工程团队在客户真实环境中完成交付。

Finding-to-Fix Workflow
365UI 接住 AI、扫描器、红队、PSIRT 和外部评估产生的安全发现,统一做证据验证、审批门控、工程交接、修复回归和防御配套。
01
导入 AI hunter、scanner、红队、PSIRT、bug bounty 或外部 assessment 的发现,保留来源、scope、owner、资产和原始证据。
02
去重、分类、标注 trigger path、影响面、披露路径、优先级和下一步实验,避免把噪声包装成战绩。
03
执行 RE 查询、可达性判断、复现条件、false-positive 检查和 lab attestation;高风险动作必须过审批门。
04
生成工程可读 evidence pack、fix brief、风险说明、测试命令和代码 owner 交接材料。
05
跑 reattack gate、回归条件、merge-ready checklist 和修复后证据,确认原始路径被阻断。
06
同步 Sigma / SIEM notes、negative corpus、清理验证和 audit trail,让修复与防御同时闭环。
客户交付物
每个 deliverable 都对应一个工程动作和验收口径:谁来修、怎么复现、什么算修好、如何检测、谁批准、证据在哪。
复现条件、trigger path、blast radius、证据文件、置信度、缺口和 next experiment。
最小修复建议、测试命令、风险说明和代码 owner 能直接接手的回归条件。
allowed / restricted / prohibited action matrix,让 AI 工具保持在客户批准边界内。
reattack gate + regression,证明原始攻击路径被阻断且安全门没有被削弱。
Sigma / YARA / IOC / query 规则草稿,并附 benign false-positive 验证。
谁批准了什么、跑了什么、证据在哪里、状态如何变化,供 PSIRT 和合规追踪。
平台
Superagent、OrgMem、BMC Red-Team Lab 与 Ironclad 构成可复用产品底座;深入现场的工程团队把它连接到客户的数据、基础设施、控制边界与验收标准。
可复用模块
Superagent 将私有检索、Agent 编排、文档处理与可替换基础设施组合为可复用运行时。
可复用模块
OrgMem 以版本化知识、审核写入与分层 Agent 记忆保留可追溯的组织经验。
可复用模块
BMC Red-Team Lab 把受控验证、可复现证据、工程交接与修复路径产品化。
可复用模块
Ironclad 以只读优先、风险门控、确认与审计证据约束基础设施操作;当前为 PoC。
可复用模块
围绕第三方 Agent 运行时提供接入、可观测性、备份与沙箱控制的部署与加固模块。
可复用模块
确定性测试样例、回放、审批门、审计记录与工程交接将系统约束在可验收边界内。
精选能力证明
双语实时口译工作流采用操作员控制、故障处理、确定性测试样例与证据化验收门禁;不代表活动部署、准确率或延迟承诺。
预订 365UI 同传精选能力证明
围绕第三方 Agent 运行时的多用户部署与加固,覆盖接入、可观测性、备份和沙箱控制;不主张基础运行时所有权、生产部署或已完成路线图缺口。
精选能力证明
围绕上游模型的服务集成、测试与运维优化,支持可复用的检索、嵌入和重排工作流;不主张专有模型或未公开性能结果。
Superagent 深度介绍
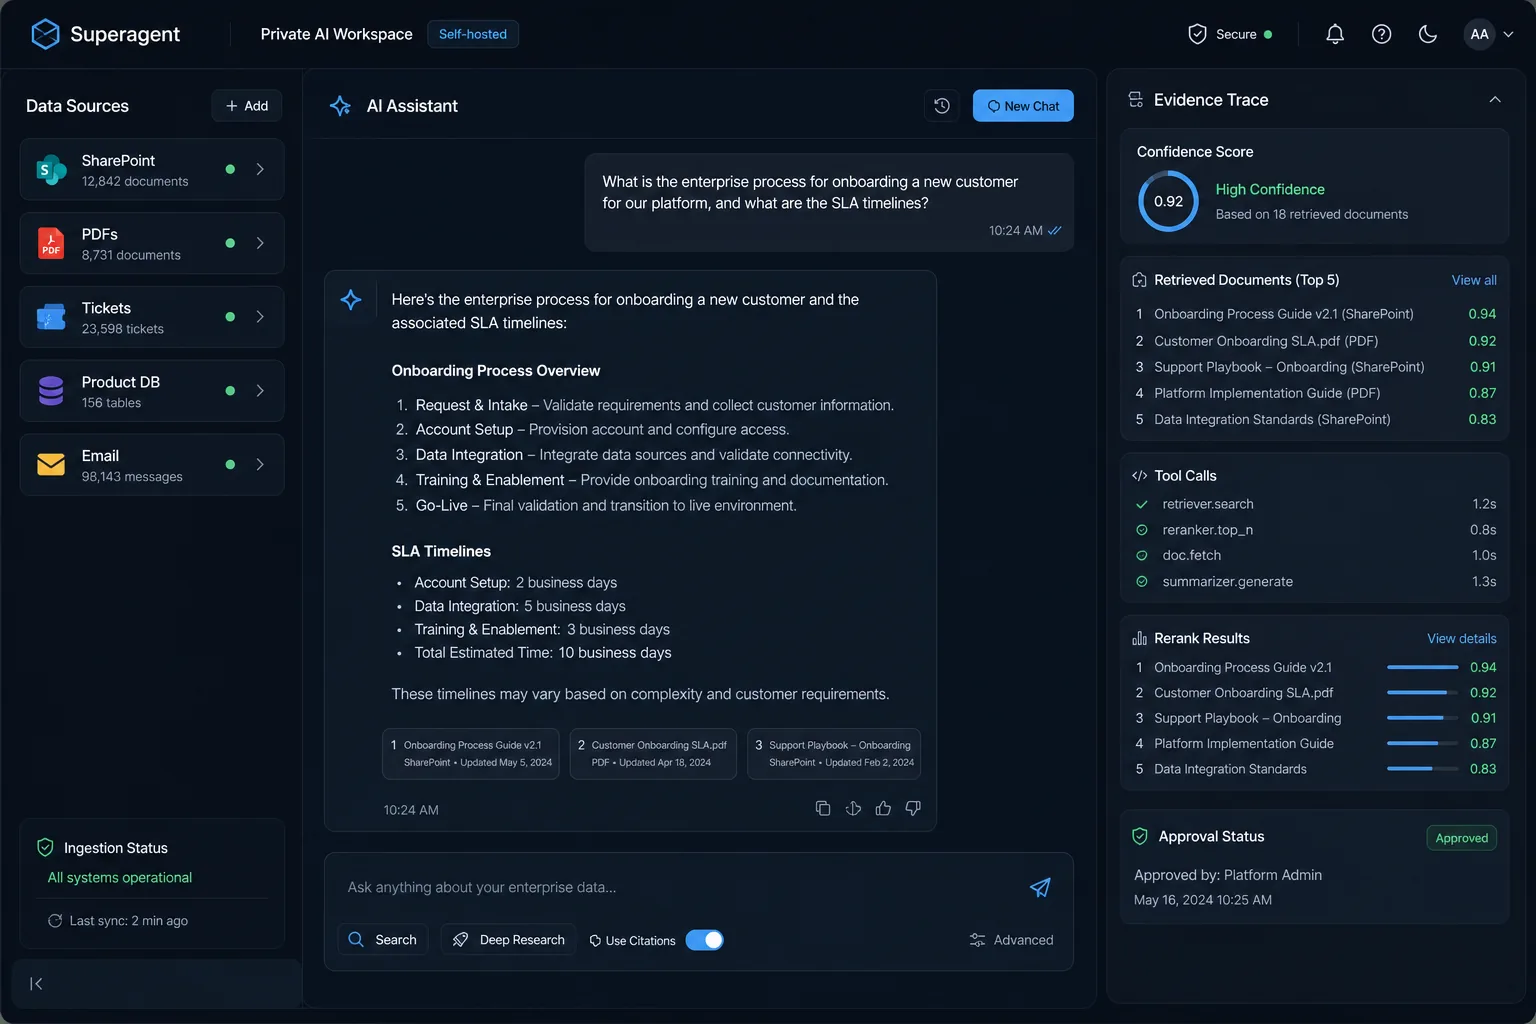
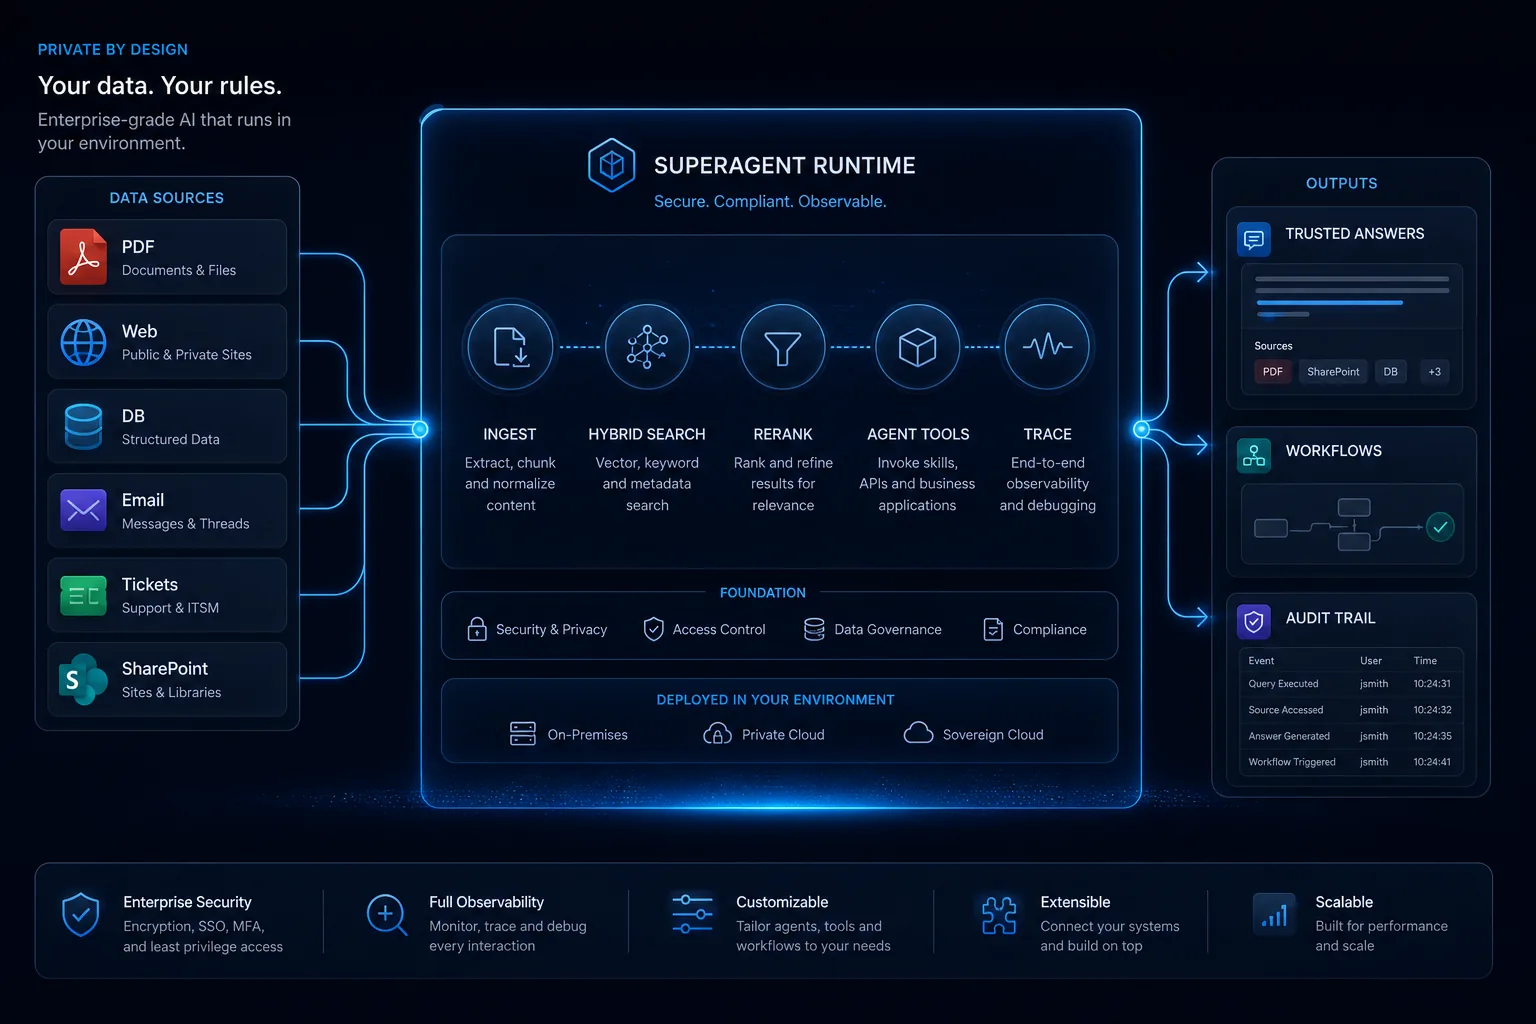
Superagent 将分散的企业知识转化为可靠的私有 RAG 与 Agent 工作流。它专为答案需要跨多种来源的场景设计:文档、网页、产品目录、工单、结构化数据库和运营数据。
核心优势是完全可控。FastAPI / LangGraph 运行时连接混合向量 + 关键词检索、Qwen3 embedding / reranking、文档解析、评测和观测;模型、向量库、搜索引擎与连接器都可替换和调优。
请求路径

爬取网站,解析 PDF 和 Office,规范化 HTML 表格,用 LLM 给 chunk 增强上下文,并随着源数据变化保持索引新鲜。
组合语义向量检索、关键词检索、RRF 融合、rerank、metadata filter、parent/sibling expansion,让答案来自正确证据。
通过 OpenAI-compatible API 暴露 RAG 和工具型 Agent,支持任务专用模型、结构化工具调用和统一 chat/completions 入口。
把产品、库存、工单、CRM、SQL 或运营数据注入回答链路,而不是只靠静态文档猜答案。
追踪每次检索和生成,比较回答质量,定位召回失败,并持续改进 chunking、ranking、prompt 和工具。
运行在客户可控环境中,模型、向量库、搜索引擎和数据连接器都可以替换。
OrgMem 深度介绍
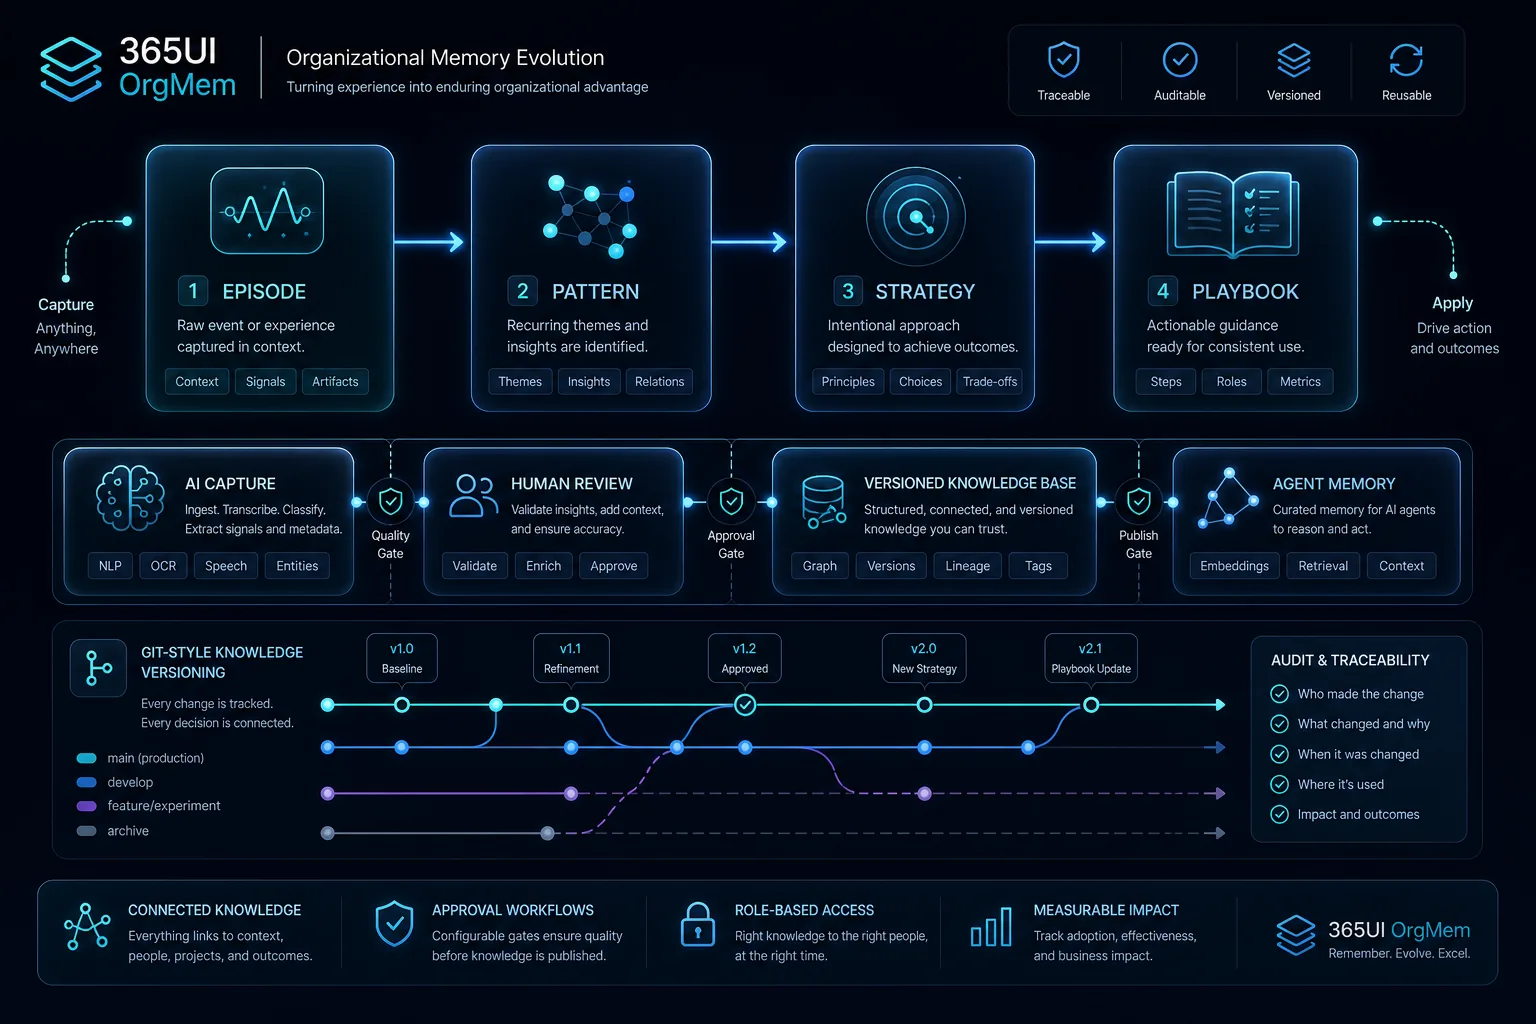
OrgMem 把组织知识、决策历史和 Agent 执行记忆放在同一个可审计系统里。它既是企业知识库,也是 Agent 的长期记忆层:人类保留最终治理权,AI 获得结构化读写和持续学习能力。
记忆演进路径
Episode → Pattern → Strategy → Playbook
失败会被记住,成功会被强化,高频且验证过的经验会晋升为正式组织 know-how。

知识存储在 Markdown + Git 中,不锁定在特定数据库或 SaaS 平台。每一次变更都有记录,支持审计、追溯和分支管理。
AI 持续捕捉和沉淀执行经验,但正式组织知识需经人工审核后方可入库,确保知识库的准确性和可信度。
语义检索与关键词精确匹配融合,配合多级精排和实体增强,兼顾概念理解和术语精确度,适合真实企业知识场景。
不仅是文档搜索。OrgMem 记录执行过程、失败分析、有效策略和团队偏好,让 AI 助手从历史经验中持续学习。
当前任务相关知识即时可用,项目级策略在会话启动时预加载,跨项目知识按需检索,减少无关信息干扰。
通过置信度、使用频率和时效性管理知识有效性;经反复验证的高价值经验自动晋升为正式操作手册。
BMC Red-Team Lab · 最新成果
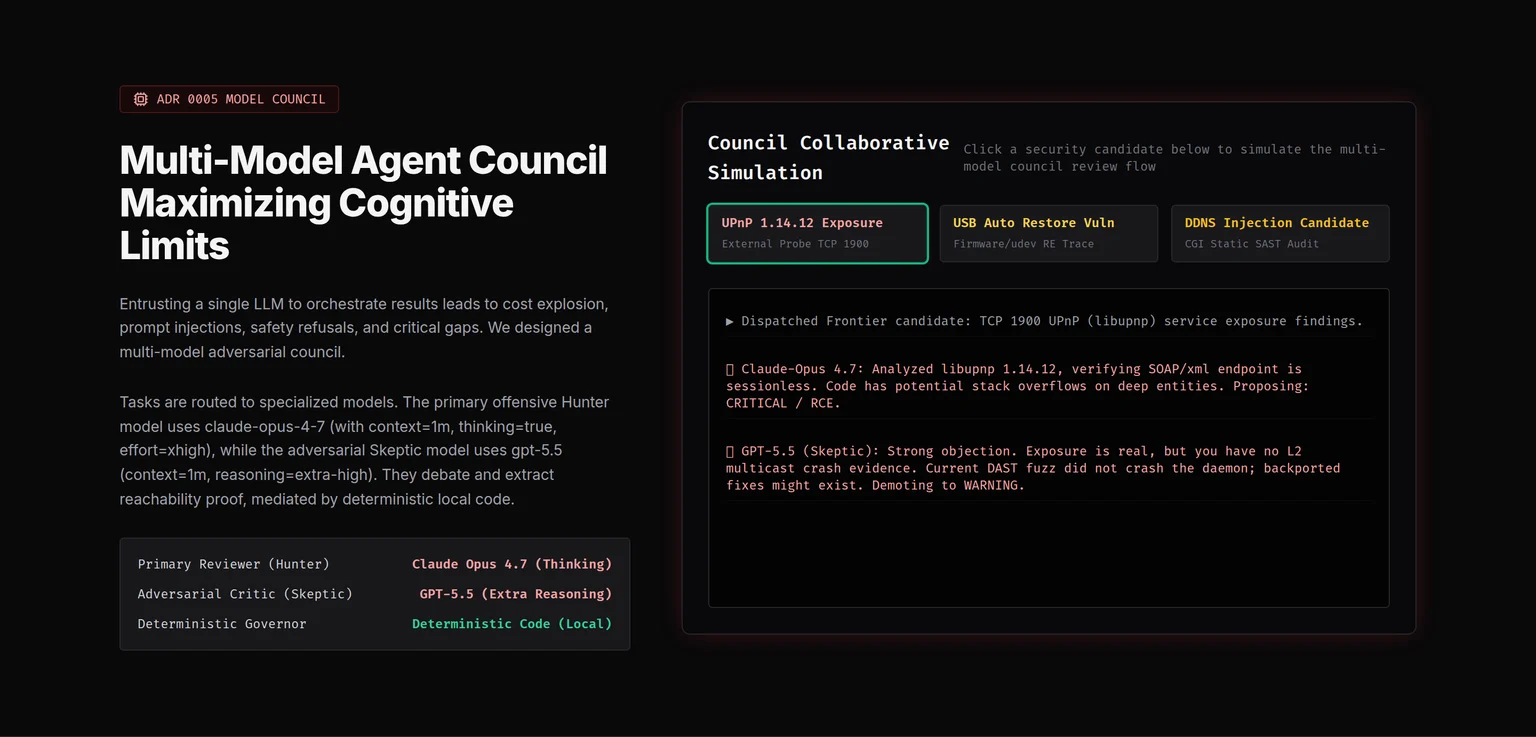
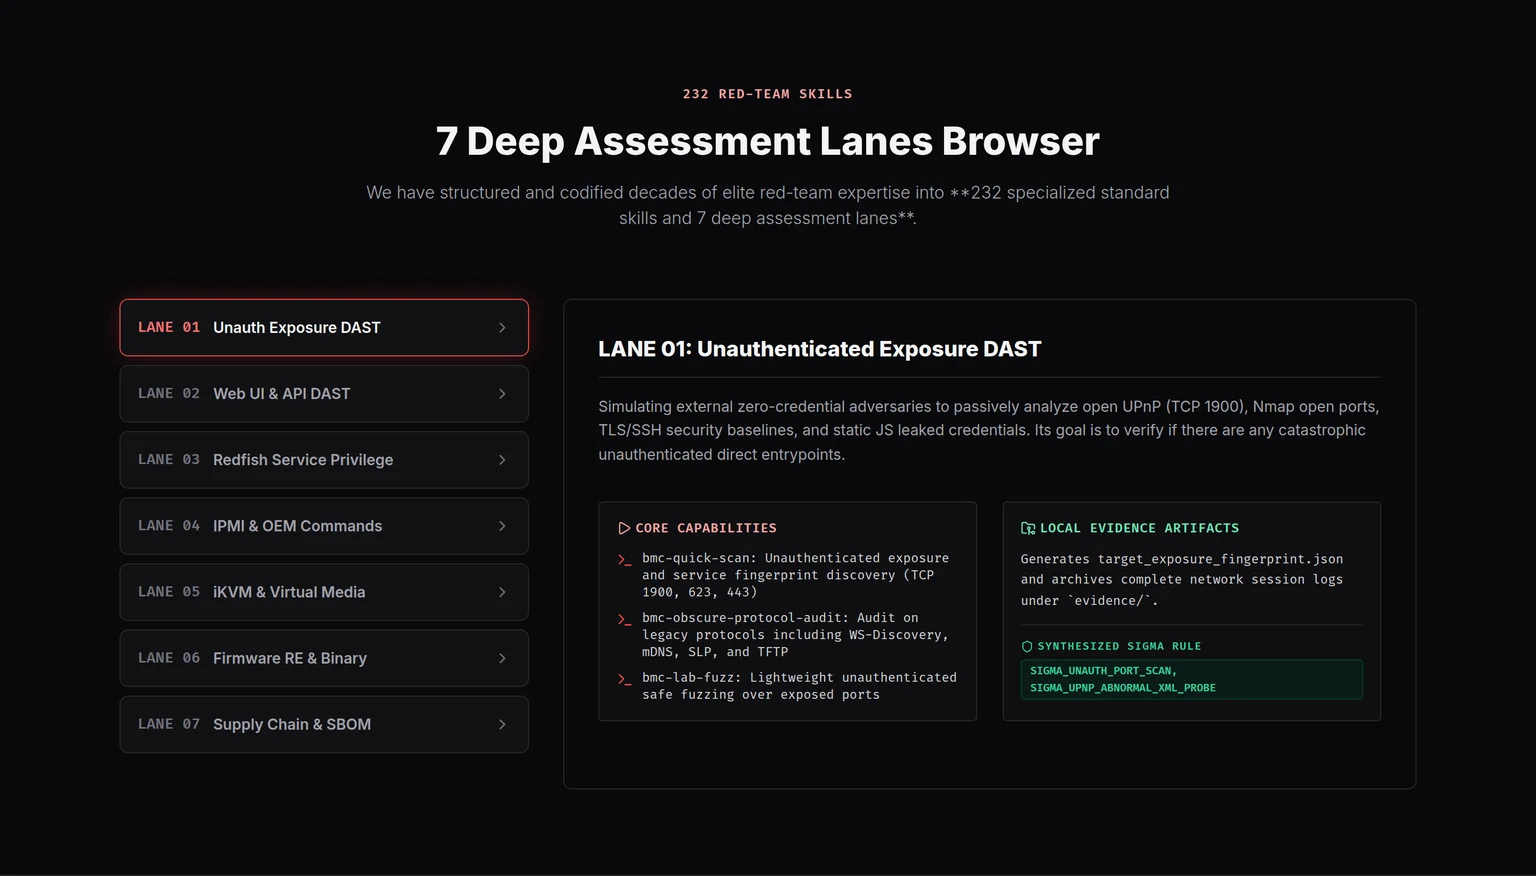
268 个专项 skill 沿 7 条深度评估通道和 11 个厂商 / 系列包路由——Unauth-DAST、Web UI、Redfish privilege、IPMI / OEM、iKVM、固件 RE、供应链 SBOM、OpenBMC / libpldm 协作修复链与 QEMU 仿真验证。多模型 Council 架构:主审查官 Hunter(Claude Opus 4.8)与唱反调合规官 Skeptic(GPT-5.5)就每个候选博弈,最终由确定性 Governor 做 Fail-Closed 决策。
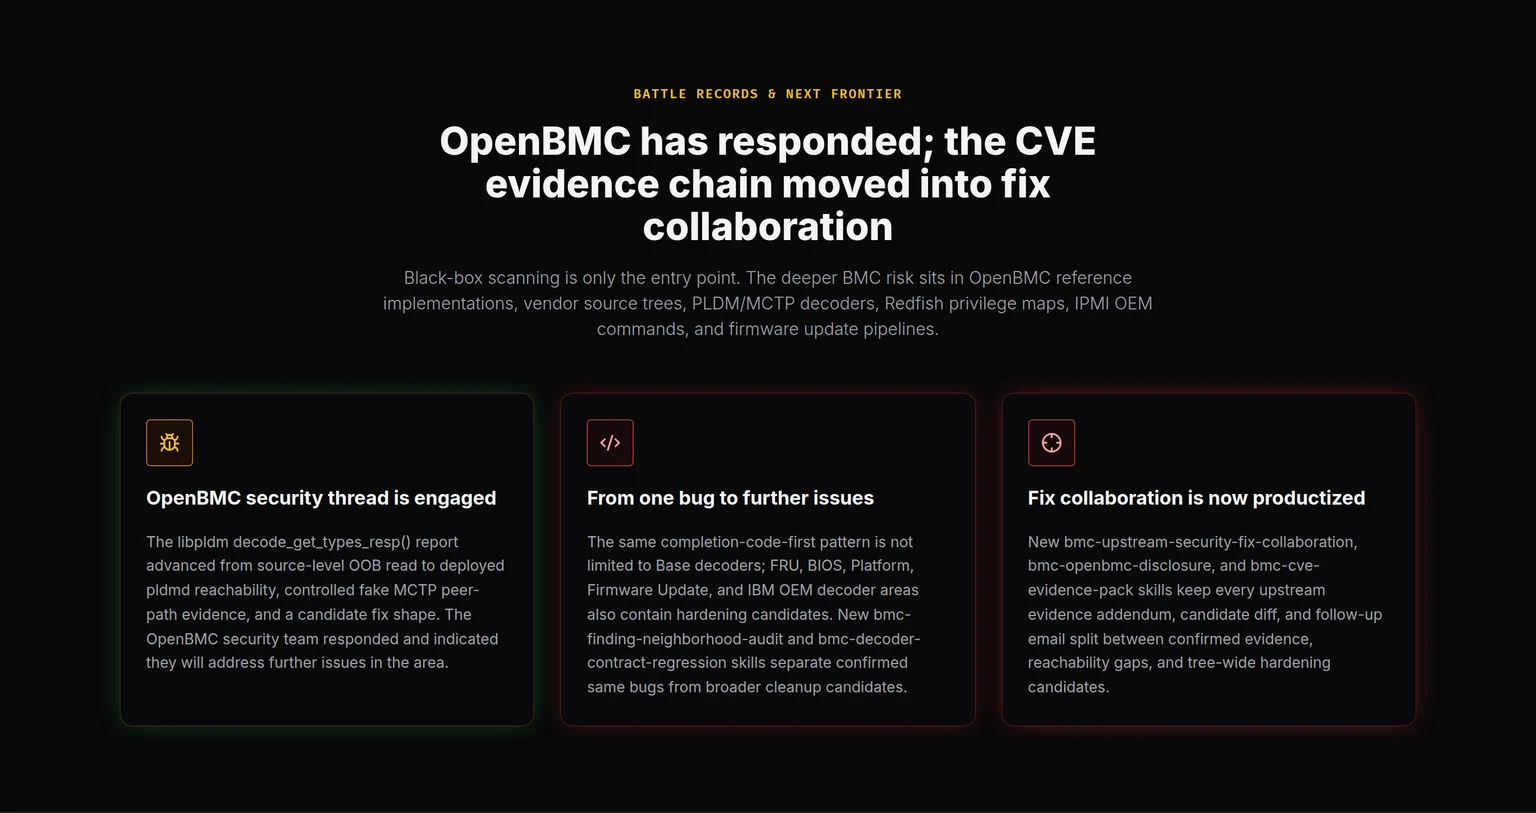
所有发现按 Proof Ladder 与 evidence priority 逐级晋升(静态候选 → deployed daemon 可达 → QEMU full-system / lab_validation_emulated → approval lease 下的真机验证),每条攻击 primitive 自动起 paired Sigma 检测规则。最新补齐 BMC-TLO 多步仿真基准、自动链式构造、fleet-scale 去重与吞吐 SLO、field journal、tool-index preflight,以及脱敏 / 投毒扫描。OpenBMC libpldm decode_get_types_resp() 报告已经进入上游修复协作。

产品驱动的现场交付
01
明确一个工作流、环境、负责人、数据边界和成功指标。
02
以固定范围、固定验收标准和可复用平台组件验证系统。
03
接入客户可控的基础设施、集成、审批、迁移与工程交接。
04
持续进行评测、治理、可观测性、升级与工作流扩展。
客户专属集成保持隔离;可复用的工程模式、测试与控制持续改进平台,不共享客户数据。
常见问题
Scanner 和 pentest 产出 findings。365UI 把 findings 变成工程能消费、管理层能追踪、防御方能检测的 evidence workflow。
可以。AI hunter、scanner、红队报告、PSIRT case、bug bounty 和外部 assessment 都可以进入同一套证据验证与工程修复流程。
BMC / firmware 足够高风险、足够难、足够技术密集,能证明 365UI 可以处理真实证据、审批、工程交接和防御闭环;打磨成熟后可以迁移到 OT、kernel driver、cloud control plane 和 AI agent ops。
AI security discovery 工具会制造更多疑似问题。缺的不是更多发现,而是私有、可控、可审计的 finding-to-fix pipeline。
Superagent + OrgMem 面向企业私有 AI、检索、Agent 与组织记忆;BMC Red-Team Lab + Ironclad 面向 AI 基础设施安全与 finding-to-fix 证据工作流。两者同等重要,共享可追溯、审批、证据与审计纪律。
OrgMem 不只是存文档。它记录决策历史、执行经验、失败分析、有效策略和 Agent 记忆,并通过人工审核与版本化流程把高价值经验晋升为正式组织知识。
可以,BMC Red-Team Lab 就是样本:268 个专项 skill 沿 7 条评估通道和 11 个厂商 / 系列包路由,多模型 Council 博弈(Hunter = Claude Opus 4.8、Skeptic = GPT-5.5、Governor = 确定性 Fail-Closed 代码),所有发现按 Proof Ladder 和 evidence priority 从静态候选推进到 daemon 可达、QEMU full-system / lab_validation_emulated,再到 approval lease 下的真机验证。系统还补齐了 BMC-TLO 多步基准、fleet-scale 去重/SLO、field journal、tool-index preflight 和 paired Sigma 防御规则。OpenBMC libpldm 报告已被官方安全团队答复跟进。
带来一个企业知识工作流或安全发现来源、明确范围与业务 owner。我们从可验证的私有 AI 试点或证据包开始,再扩展为长期运行的控制平面。